- Published on
超越原型:打造有韧性的 AI 工程
- Authors

- Name
- 俞凡
AI 领域唯一不变的,就是变化本身。提示工程、上下文工程、Harness 工程、循环工程、隔离工程 —— 光是这些术语轮番轰炸,就够让人觉得头大了。
我不敢自称精通所有热词,但在日常交付 AI 系统的过程中,确实吃过不少亏,其中最扎眼的一条残酷现实是:把漂亮的原型做成能扛住生产的韧性 AI 系统,才是今天真正的难题。
在演示里让大语言模型(LLM)漂亮的答对一次,很容易。可要让同一条工作流在意外延迟、恶意提示注入、输出漂移、上游 schema 变更的冲击下仍然扛得住,完全是另一回事。
生产环境里,AI 不能当黑盒。每条 AI 工作流都要有明确的输入、严格受限的输出、确定性的失败路径,以及可持续度量的质量门槛,就像其他任何关键软件组件一样。
本文将拆解一套可落地的运营标准、代码模式和自动化评估流水线,帮你更安全的交付 AI 工作流。我会重点讨论用 LLM 解决边界清晰、成败可客观判定的任务,比如 SQL 生成或数据抽取。以自然语言转 SQL(Text-to-SQL)接口为例:如果模型 100 次里有 99 次写出完美优化的查询,却在第 100 次幻觉出一张不存在的表,或写出 UPDATE 而不是 SELECT,这就不是可靠应用,而是一枚迟早会在生产环境爆炸的炸弹。
要说清楚,这不是面面俱到的 AI 工程教科书。AI 领域变得太快,没人能宣称自己全搞明白了。你将看到的是一线实战里目前仍管用的反思与做法,帮你搭好架构护栏(guardrails)和确定性安全网,避免在生产环境里翻车。
Harness 架构:用确定性包裹概率
可以说,AI 工程里最重要的一条原则是:非确定性必须被约束,而不是被忽视。LLM 内核天生是概率的;因此,外围架构必须绝对、确定,做法是把 LLM 封装进多层软件 harness(套在模型外的约束与编排外壳)。
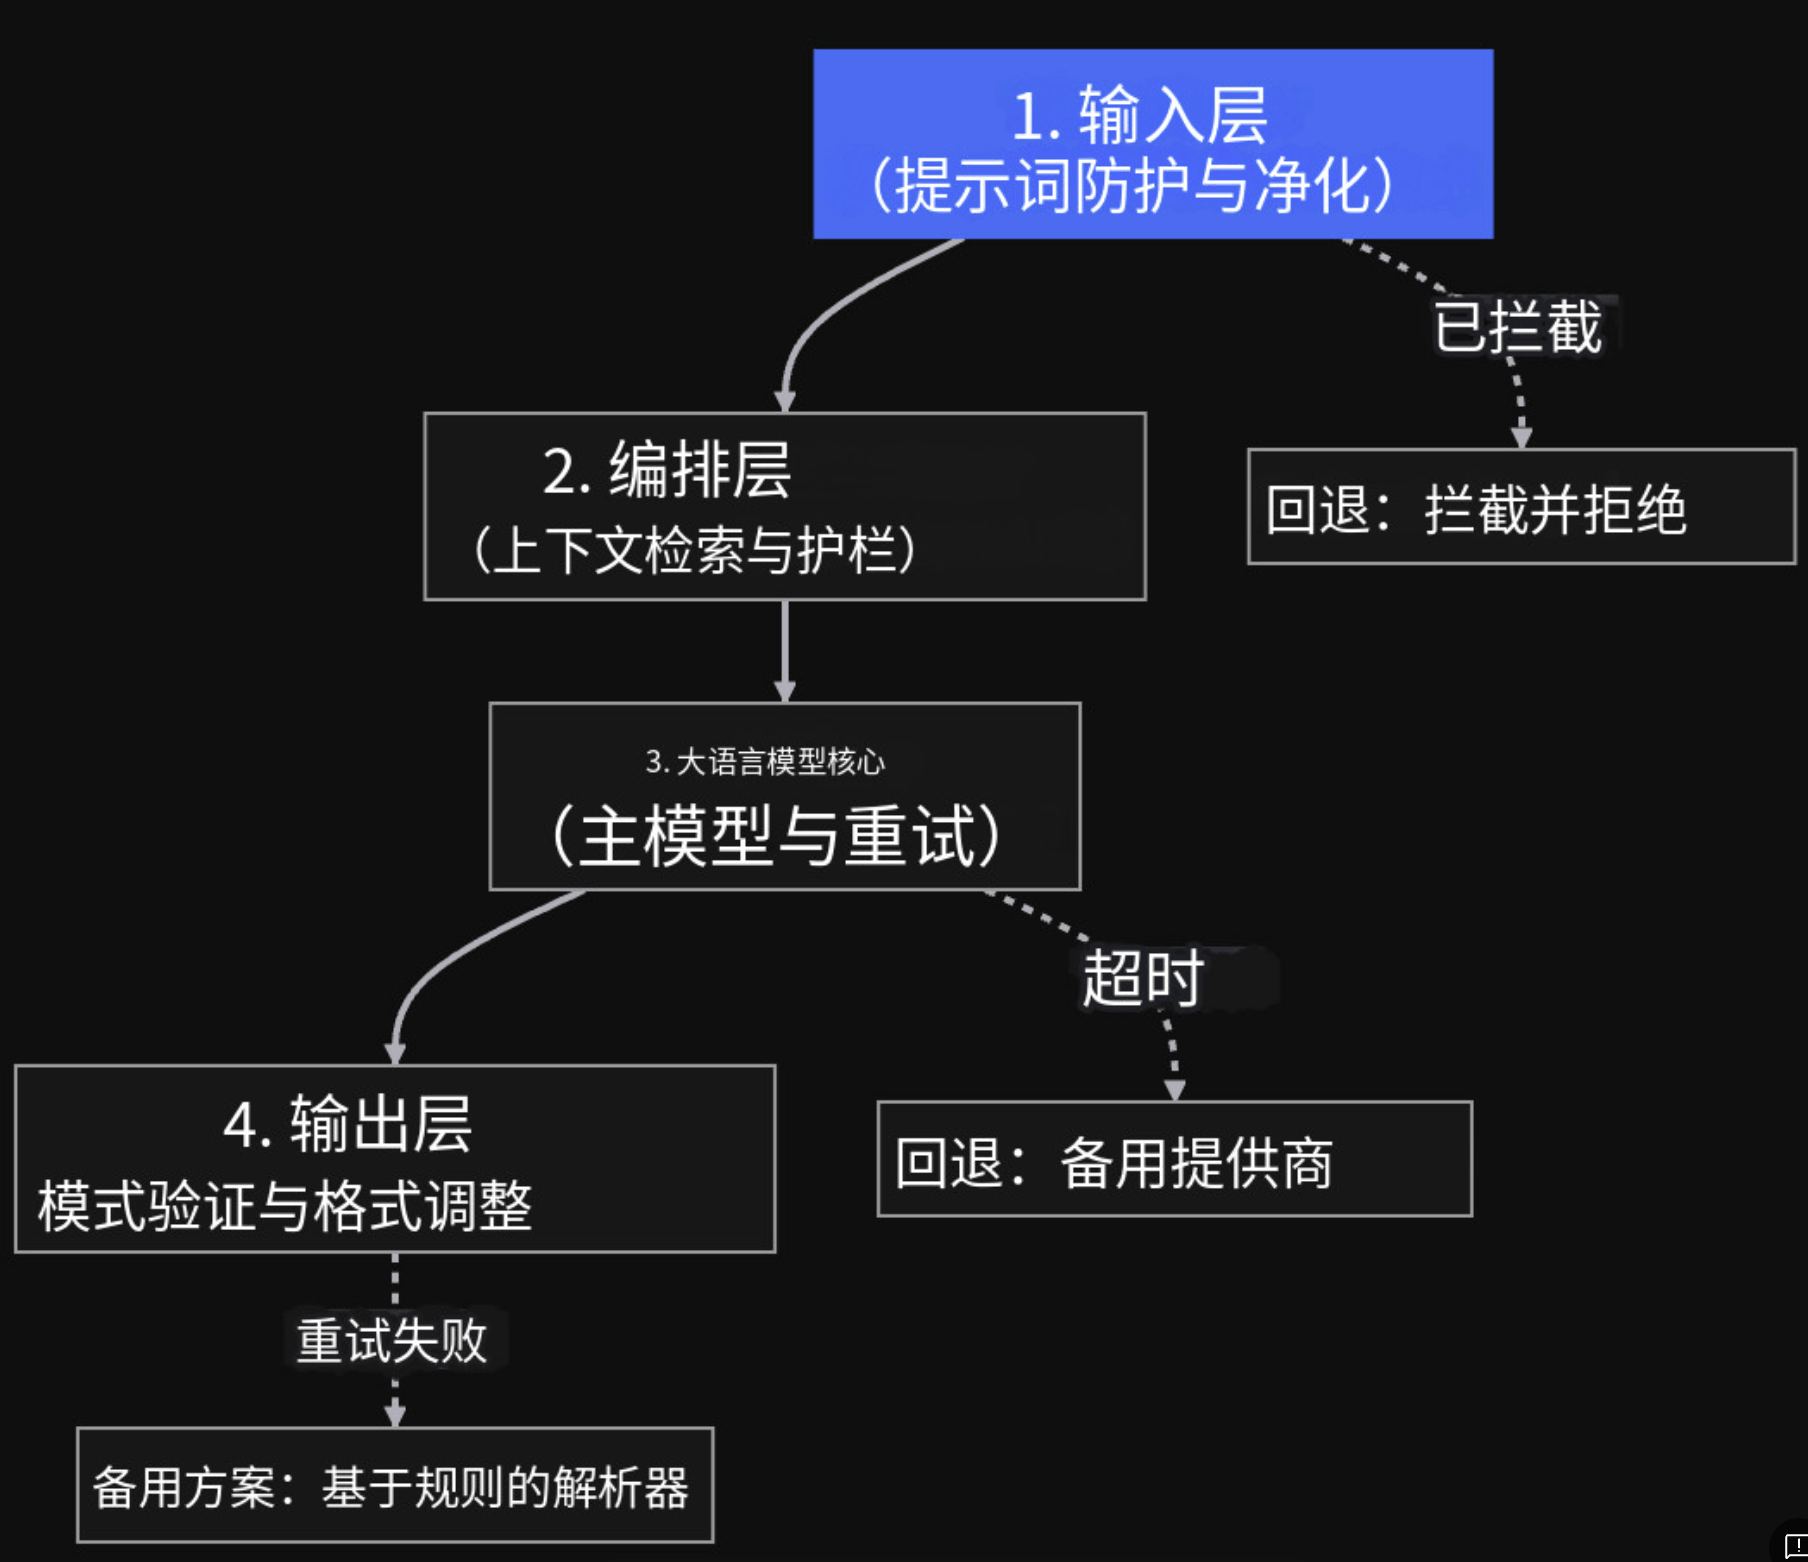
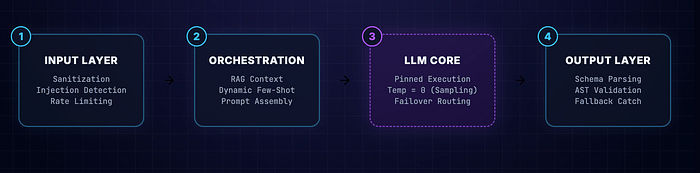
一次请求如何穿过 Harness 的四层架构,大致如下:
- 输入护栏层(第一道防线)
- 内容清洗:清理原始用户请求中的非法字符或格式,再交给后续系统。
- 提示注入检测:扫描输入中试图绕过或劫持 AI 核心指令的恶意指令(prompt injection)。
- 限流与鉴权:确认用户有权限发起请求,且未超出用量上限。
- 编排层(上下文组装)
- 动态上下文 / RAG 片段:检索相关外部数据(文档片段、数据库记录等),让回答落在事实基础上。RAG 即检索增强生成。
- 动态 Few-Shot(少样本示例)组装:拉取结构相似的历史样例,示范输出格式与推理路径。
- 系统提示渲染:把清洗后的用户输入、检索上下文、few-shot 样例与硬编码系统指令,拼成最终结构化提示。
- LLM 核心引擎(执行)
- 锁定模型版本执行:把编译好的提示路由到特定、锁定的模型版本,避免静默升级带来意外回退。
- Temperature = 0:迫使模型尽量选择最高概率的 token,让输出尽可能确定(仍无法保证绝对确定)。
- 延迟/超时拦截:对生成过程施加严格时限;供应商卡住时自动切断并做故障切换(failover)。
- 输出校验层(最后一道安全网)
- Schema 解析(例如用 Pydantic):把 LLM 返回的原始字符串强制解析成预定义数据结构(如特定 JSON),再交给下游。
- AST/SQL 约束检查:从结构上校验生成的代码或数据库查询,确保不含破坏性命令(例如拦截
DROP TABLE或UPDATE)。AST 即抽象语法树。 - 优雅捕获与回退:拦截前述检查的失败,触发预定义回退(通用错误提示或重试循环),而不是把下游应用一并打崩。
护栏:基础设施级的安全边界
提示工程不是安全。对 LLM 说「不要改数据库」或「只从允许的表里选行」,会在语义越狱(semantic jailbreak,用措辞绕过限制)或提示注入面前失效。安全必须落在基础设施与逻辑层,原生强制执行,并且与提示彻底解耦。
规则 1:隔离与最小权限(Least Privilege)
AI 服务必须用专用、权限被严重收紧的服务账号连接目标系统。若智能体的目标是查指标,就用只读数据库用户,严格限制为对白名单(whitelist)表的 SELECT。生产应用的写权限凭证,绝不能出现在 AI 智能体的运行时容器环境里。
规则 2:不可妥协的输入/输出校验
做 Text-to-SQL 这类应用时,输出 harness 必须在查询真正打到数据存储之前,先把每条生成语句送进 AST 校验器。
# security/sql_validator.py
import re

_BANNED_KEYWORDS = {"INSERT", "UPDATE", "DELETE", "DROP", "ALTER", "TRUNCATE", "CREATE", "EXEC", "EXECUTE"}
_TABLE_REF_RE = re.compile(r"\bFROM\s+([\[\]\w\.]+)", re.IGNORECASE)

def validate_sql(
    sql: str,
    allowed_tables: set[str],
    default_row_limit: int | None = 50,
) -> str:
    if not sql or not sql.strip():
        raise ValueError("SQL string is empty.")

    sql = sql.strip()

    # 立即拒绝任何非 SELECT 语句
    if not re.match(r"^\s*SELECT\b", sql, re.IGNORECASE):
        raise ValueError(f"Only SELECT queries are allowed. Got: {sql[:80]!r}")

    upper_sql = sql.upper()
    for keyword in _BANNED_KEYWORDS:
        if re.search(rf"\b{keyword}\b", upper_sql):
            raise ValueError(f"Prohibited keyword detected in query: {keyword}")

    # 隔离并校验目标表 schema
    table_refs = _TABLE_REF_RE.findall(sql)
    if not table_refs:
        raise ValueError("Query contains no explicit FROM clause.")

    expanded_allowed = allowed_tables | {t.split(".")[-1] for t in allowed_tables}
    for ref in table_refs:
        normalized = re.sub(r"[\[\]]", "", ref.upper()).strip()
        if normalized not in expanded_allowed:
            raise ValueError(
                f"Unauthorized table reference: {ref!r}. "
                f"Allowed tables: {', '.join(sorted(allowed_tables))}"
                )

    # 自动追加或限制最大行数,以防 OOM 错误
    if default_row_limit is not None and "LIMIT" not in upper_sql:
        sql = f"{sql} LIMIT {default_row_limit}"

    return sql
这个函数就是一层确定性安全网 —— 卡在 LLM 原始输出与数据库之间的最后一道护栏。它不「相信」AI 会写出安全查询,而是在允许执行之前主动解析、清洗生成的 SQL。
它这样保护系统:
- 强制只读执行:不以
SELECT开头的查询立刻拒绝,确保模型只查数据、不改数据。 - 拦截破坏性命令:对照硬编码黑名单(
_BANNED_KEYWORDS)扫描。若模型幻觉或被诱导写出DROP、UPDATE、INSERT、ALTER等,函数会抓住并抛错。 - 强制白名单表:用正则提取查询试图读取的表(
FROM ...),再与显式提供的allowed_tables交叉核对。若模型去碰受限数据(例如本应只看产品指标,却去查 HR 表),执行会被阻断。 - 防止内存过载(OOM,内存耗尽导致崩溃):无界查询可能一次拉入数百万行,拖垮应用。若模型忘了
LIMIT,函数会自动在末尾补上安全默认值(例如LIMIT 50)。
把 LLM 生成的 SQL 过一遍这个函数,即便模型幻觉或彻底翻车,也无法腐蚀数据库、越权读数据,或拖垮基础设施。
具体模式:多厂商 Provider 故障切换
生产系统不能绑死在单一 LLM 供应商上。上游若宕机或延迟严重恶化,系统必须能动态改道。
下面是一份用 LangChain 管理弹性、可持久会话的参考实现:一旦触发阈值,就自动故障切换到备选厂商(例如从 Anthropic 切到 Azure OpenAI)。
# llm/provider_manager.py
import logging
from langchain_anthropic import ChatAnthropic
from langchain_core.language_models import BaseChatModel
from langchain_openai import AzureChatOpenAI
from config import CONFIG

logger = logging.getLogger(__name__)

class ProviderManager:
    def __init__(self) -> None:
        self._use_fallback = False
        self.primary: BaseChatModel = ChatAnthropic(
            anthropic_api_url=CONFIG.AZURE_CLAUDE_ENDPOINT,
            anthropic_api_key=CONFIG.AZURE_CLAUDE_API_KEY,
            model=CONFIG.AZURE_CLAUDE_DEPLOYMENT,
            temperature=0,
            max_retries=0,
        )
        self.fallback: BaseChatModel = AzureChatOpenAI(
            azure_endpoint=CONFIG.AZURE_OPENAI_ENDPOINT,
            api_key=CONFIG.AZURE_OPENAI_API_KEY,
            api_version=CONFIG.AZURE_OPENAI_API_VERSION,
            azure_deployment=CONFIG.AZURE_OPENAI_DEPLOYMENT,
            temperature=0,
        )

    @property
    def active(self) -> BaseChatModel:
        return self.fallback if self._use_fallback else self.primary

    @property
    def is_fallback_active(self) -> bool:
        return self._use_fallback

    def switch_to_fallback(self) -> None:
        if not self._use_fallback:
            logger.warning(
                "LLM provider switching to fallback (Azure OpenAI) for remainder of session"
            )
            self._use_fallback = True

provider_manager = ProviderManager()
这段代码相当于自动故障切换开关:主供应商宕机或延迟严重时,应用仍能在线。
它大致做三件事:
- 配置双供应商:启动时同时初始化主 LLM(Anthropic Claude)与跨厂商备用 LLM(Azure OpenAI)。很容易扩展到更多供应商。
- 管理活跃状态:默认充当路由器,把流量指向主模型。
- 执行切换:外部逻辑一旦检测到失败或超时,调用
switch_to_fallback(),把内部状态翻成_use_fallback = True,该会话后续请求无缝切到备用模型。
要在单条 chain 或多步图智能体上安全调用,把执行包进异步超时 harness:
# llm/failover.py
import asyncio
import logging
from collections.abc import Callable
from typing import Any
from langchain_core.runnables import Runnable
from config import CONFIG
from llm.provider_manager import provider_manager

logger = logging.getLogger(__name__)

async def invoke_with_failover(
    primary_runnable: Runnable,
    fallback_runnable: Runnable,
    inputs: dict,
    invoke_config: dict | None = None,
) -> Any:
    """
    带超时调用 primary_runnable。超时或发生任何异常时,持久切换到备用供应商,并改用备用路径执行。
    """
    if provider_manager.is_fallback_active:
        return await fallback_runnable.ainvoke(inputs, config=invoke_config)

    try:
        return await asyncio.wait_for(
            primary_runnable.ainvoke(inputs, config=invoke_config),
            timeout=float(CONFIG.LLM_FAILOVER_TIMEOUT),
        )
    except Exception as exc:
        logger.error(
            "Primary LLM call failed (%s: %s) — switching to fallback for session",
            type(exc).__name__,
            exc,
        )
        provider_manager.switch_to_fallback()
        return await fallback_runnable.ainvoke(inputs, config=invoke_config)

async def invoke_agent_with_failover(
    build_fn: Callable[[], Any],
    invoke_inputs: dict,
    invoke_config: dict | None = None,
) -> Any:
    """
    构建并调用带故障切换支持的 LangGraph 智能体。
    build_fn 是一个无参可调用对象,用于在备用 LLM 已激活的状态下重新构建智能体拓扑。
    """
    agent = build_fn()

    if provider_manager.is_fallback_active:
        return await agent.ainvoke(invoke_inputs, config=invoke_config)

    try:
        return await asyncio.wait_for(
            agent.ainvoke(invoke_inputs, config=invoke_config),
            timeout=float(CONFIG.LLM_FAILOVER_TIMEOUT),
        )
    except Exception as exc:
        logger.error(
            "Agent LLM call failed (%s: %s) — switching to fallback for session",
            type(exc).__name__,
            exc,
        )
        provider_manager.switch_to_fallback()
        agent = build_fn()
        return await agent.ainvoke(invoke_inputs, config=invoke_config)
这才是真正让故障切换生效的执行包装层,它夹在应用与 LLM 之间,强制执行严格的性能边界。
工作方式简述:
- 强制硬超时:每次 LLM 请求都包在异步超时(
asyncio.wait_for)里。主供应商超时后,果断断连,而不是无限等。 - 无缝切换(
invoke_with_failover):主调用超时或抛错时,拦截失败、让ProviderManager切换,并用备用模型自动重试同一请求。 - 动态重建智能体(
invoke_agent_with_failover):对复杂多步智能体(如 LangGraph),中途只换 API key 不够。该函数拦截失败后,用新的备用模型当场重建智能体内部逻辑图,再无缝续跑。
上下文工程:管好高价值 Token
要把上下文窗口当成珍贵的内存带宽,而不是杂乱草稿纸。每一段背景噪音或不相关数据,都会稀释模型对真正重要内容的有效注意力。
上下文窗口层级
始终按权威性、相关性、时效性,显式组织上下文层级:
- 系统指令:角色定义、操作边界、格式规则(最高层)。
- 上下文块:RAG 检索片段、工具输出、外部参数(用明确分隔符包裹,例如
<context>…</context>)。 - Few-Shot 样例:目标执行模式的示范。
- 对话轮次历史:大胆裁剪与摘要。
- 当前用户载荷:当下这一次请求(放在最底部,以便对系统提示等静态部分做前缀缓存 —— 把稳定前缀放前以复用缓存、降本加速)。
把层级摆对只是第一步;真正的性能提升,来自如何动态填充这些层。我们单独看第三层:Few-Shot 样例。把三四个靠谱例子直接写进提示模板然后收工,很诱人——但这套做法根本撑不住生产规模。
具体模式:语义动态 Few-Shot 提示
把静态 few-shot 硬塞进提示,是一种反模式(anti-pattern)。固定提示选不中生产请求那变幻莫测的分布。正确做法是:建一个样例检索库,用语义向量搜索在运行时捞出结构相近的上下文模式。
# prompt/dynamic_context.py
from langchain_core.vectorstores import VectorStore

async def build_dynamic_few_shot_context(
    user_input: str,
    example_store: VectorStore,
    k: int = 3,
) -> str:
    """
    动态获取语义上最相似的前 k 条历史样例,用以塑造更合适的语气、结构与推理风格。
    """
    relevant_examples = await example_store.similarity_search(user_input, k=k)

    formatted_blocks = []
    for ex in relevant_examples:
        block = f"<example>\nInput: {ex.metadata['input']}\nOutput: {ex.metadata['output']}\n</example>"
        formatted_blocks.append(block)

    formatted = "\n\n".join(formatted_blocks)
    return f"<examples>\n{formatted}\n</examples>"
它不再依赖静态字符串,而是嵌入当前用户请求,在向量库中检索最相关的三条历史样例,再格式化成块。在回答前先给模型看「如何解一道结构相同的题」,准确率与格式一致性往往会大幅上升。
这套做法常常能省掉微调(fine-tuning)。很多团队一见基座模型在复杂指令、边界情况或小众格式上吃力,就急着微调定制模型。微调带来巨大的运维开销与技术风险 —— 训练流水线、持续数据策展、托管定制权重的成本。动态 few-shot 提示能让现成基座模型在运行时拿到恰好需要的上下文模式,从而压榨出基座模型的最大性能。
可一旦系统开始动态注入上下文、随时替换样例,提示环境就高度流动了,不能再靠「抽查」或凭感觉的 vibe check(凭感觉抽查)来证明工作流准确,而是需要客观证明:上下文工程在每个边界案例上都在变好。于是我们来到生产最关键的一环:严格评估。
评估集与 CI/CD
要有底气部署 AI 系统,至少要跑两套测试架构:完全 mock 掉 LLM、专门测套件/解析器/逻辑门的单元测试;以及对评估集上的真实 LLM 响应打分的 AI 集成/回归测试。
确定性指标 vs 概率性指标
指标本质上分两类,选哪一类取决于你在解什么问题。
- 确定性指标:适合答案边界清晰的任务,如 SQL 生成、OCR、实体抽取。又快又免费,且完全可复现。例子与传统机器学习指标高度重叠——准确率、精确率、召回率、F1、ROC AUC、PR AUC 等。
- LLM 评判(LLM-Judge)指标:若系统输出是自由文本,自动化测试通常需要另一个语言模型来算分。适合 RAG、摘要或没有唯一正确答案的开放生成。常见度量包括忠实度(Faithfulness)、答案相关性(Answer Relevancy)、语义相似度,以及上下文召回率(Context Recall)。
分清这一点很关键:概率性指标会在测试中真实调用 LLM API,给 CI/CD 流水线引入延迟与 token 成本;确定性指标则在本地瞬间跑完。
无论用哪类指标,你都需要一个集中、受版本控制的方式,在上线前定义「怎样算通过」。
Manifest 文件
不要把评估逻辑硬编码进测试文件,而要在版本库里的声明式配置清单(manifest,例如 eval_sets/<workflow_name>/manifest.yaml)中定义断言。
# eval_sets/sql_generation_chain/manifest.yaml
workflow: sql_generation_chain
version: v1
blob_path: eval-sets/sql_generation_chain/v1.jsonl
thresholds:
  accuracy: 0.95
这份 manifest 是 CI/CD 流水线的单一真相来源。把评估数据集位置(blob_path)与通过标准(thresholds)从 Python 测试代码里解耦后,团队只需用可读的合并请求(pull request),就能改质量门禁(quality gate)或指向新评估集。测试流水线会动态读这份文件、拉取数据、强制执行阈值。
若工作流依赖基于 LLM 的指标:
# eval_sets/rag_workflow/manifest.yaml
workflow: rag_workflow
version: v1
blob_path: eval-sets/rag_workflow/v1.jsonl
thresholds:
  faithfulness: 0.85
  answer_relevancy: 0.80
  context_recall: 0.75
能用确定性指标就尽量用。例如 Text-to-SQL:不必评估查询文本本身,而应评估目标库返回的数据数组,做客观一致性校验(parity check):
# testing/eval_methods.py
from typing import Any
import pytest

async def test_sql_example(
    workflow: Any,  # 目标 text-to-sql 生成链
    example: Any,   # 含原始输入与标准期望 SQL 的实体
    db_connection: Any,
) -> bool:
    """
    通过将生成查询得到的结果集,与确定性评估数据集上的已知标准答案做对比,来评估查询质量。
    """
    generated_sql = await workflow.generate(example.input)
    validated_query = validate_sql(generated_sql, allowed_tables={"USERS", "METRICS"})

    # 在静态评估数据库快照上并发执行这两条查询
    expected_rows = await db_connection.fetch_all(example.expected_sql)
    actual_rows = await db_connection.fetch_all(validated_query)

    # 对结果行做一致性校验,忽略语法顺序上的细微差异
    assert set(map(tuple, actual_rows)) == set(map(tuple, expected_rows))
这条集成测试不关心模型用了 JOIN 还是子查询,也不关心关键字大小写是否与参考查询一致。直接比对 SQL 字符串很脆,假阴性会不断冒出来。把期望查询与生成查询都放在静态评估库快照上执行,你测的才是真正重要的事:AI 取回的数据是否完全一样?
接入 CI/CD 环境
集成测试运行器读取 manifest,拉取版本锁定的远程数据,给生产变体打分,把实验记入跟踪设施(例如 MLflow),并在质量指标下滑时阻断环境部署。
# tests/integration/test_quality_gates.py
import os
import json
import yaml
import pytest
import mlflow
from azure.storage.blob import BlobServiceClient
from src.workflows.infosec_rag import InfosecRagChain
from tests.integration.eval_runner import EvalRunner

MANIFEST_PATH = "eval_sets/infosec_rag/manifest.yaml"

@pytest.fixture(scope="module")
def manifest():
    with open(MANIFEST_PATH) as f:
        return yaml.safe_load(f)

@pytest.fixture(scope="module")
def eval_set(manifest):
    client = BlobServiceClient.from_connection_string(os.environ["AZURE_STORAGE_CONNECTION_STRING"])
    blob = client.get_blob_client(container=os.environ["EVAL_BLOB_CONTAINER"], blob=manifest["blob_path"])
    lines = blob.download_blob().readall().decode().strip().splitlines()
    return [json.loads(line) for line in lines]

@pytest.mark.integration
@pytest.mark.asyncio
async def test_infosec_rag_quality(manifest, eval_set):
    runner = EvalRunner(workflow=InfosecRagChain())

    # 会话跟踪细节原生关联到 Git commit 哈希
    with mlflow.start_run(run_name=f"{manifest['workflow']}_{manifest['version']}"):
        mlflow.set_tags({"workflow": manifest["workflow"], "version": manifest["version"]})
        results = await runner.run(eval_set, metrics=list(manifest["thresholds"].keys()))
        mlflow.log_metrics(results.aggregate())

    # 断言结果始终紧扣质量参数
    thresholds = manifest["thresholds"]
    aggregated_metrics = results.aggregate()
    for metric, threshold in thresholds.items():
        actual = aggregated_metrics[metric]
        assert actual >= threshold, f"{metric} has regressed. Found {actual:.3f}, requires >= {threshold}"
这份脚本是 CI/CD 流水线的守门人,它把前文所有零件拧成一张自动安全网。
测试运行时发生的事:
- 动态准备:
pytestfixture 读取 YAML manifest,连上云存储(此处是 Azure Blob),下载指定评估集。 - 可审计:用
mlflow.start_run()包住执行,结果写入跟踪服务器,形成不可篡改的审计轨迹;若某次提示改动无意拉低表现,可直接追到具体 Git commit。 - 硬性叫停:最后的
for循环遍历指标并触发assert。只要开发者的改动让准确率或忠实度哪怕低过 manifest 阈值一点点,测试失败、流水线中断,有问题的 AI 工作流就被挡在生产门外。
结语
上线 AI 功能,拼的不是谁能在试用台(playground)里写出最机灵的提示,而是谁能在非确定性内核周围,建出最有韧性的基础设施。
靠严格的输入输出护栏、供应商故障切换、动态注入上下文样例,以及用硬性、指标驱动的评估集卡住每次发布,你就能给 LLM 祛魅。别再把它们当成不会犯错的黑盒,而应把它们当作本该如此的东西:可测试、可验收的标准软件组件。
AI 版图仍会飞快演变;但把这些模型真正用进现实世界,靠的始终只有一条:严谨的工程纪律。